Audit d'entrée
Un inventaire de votre surface IA — quel outillage existe déjà, ce qui relève du shadow IT, où la connaissance dérive silencieusement entre systèmes. Ce document est le vôtre, à utiliser avec ou sans nous.
Voir comment nous procédonsAI Architect est la pratique de Clément Deust, architecte de solutions, architecte technique et AI builder. Son cœur est une méthode pour travailler avec l'IA, développée sur ses propres projets : rigueur, méta-prompting adapté à chaque cas, le bon modèle et le bon niveau d'effort pour chaque tâche, et des principes de programmation qui gardent le résultat proche d'un code de production écrit par un humain. Deux usages : des migrations de code et d'outils au prix fixe par livrable, chiffrées après un court pilote payant sur votre propre code, et l'adoption et la montée en compétence des équipes, environnements réglementés compris. La pile open source derrière elle : 97,8 % de Recall@10 sur LongMemEval-S (Cortex v4.20.0), 5 signaux de récupération fusionnés, zéro LLM qui juge un LLM.
Si un agent énonce un fait, ce fait remonte à une mémoire, un fichier, un commit ou une citation. Aucune assertion ne vit sans sa trace.
La vérification est déterministe : analyse de graphe, contrôles sémantiques, décomposition atomique des affirmations. Nous ne demandons jamais à un modèle si un autre modèle a raison.
Cortex applique la neuroscience — activation par propagation, cycles de consolidation, élagage microglial — pour que les agents retiennent ce qui a fonctionné, pas seulement ce qui s'est passé.
Chaque PRD, PR, décision et étape de raisonnement est journalisée et revue. Conçu selon la même exigence que les logiciels des systèmes financiers.
Releases stables, paquets publiés ou installation par marketplace, et une suite de tests qui passe aujourd'hui. Ce sur quoi un client peut compter dès maintenant.
Mémoire persistante pour Claude Code.
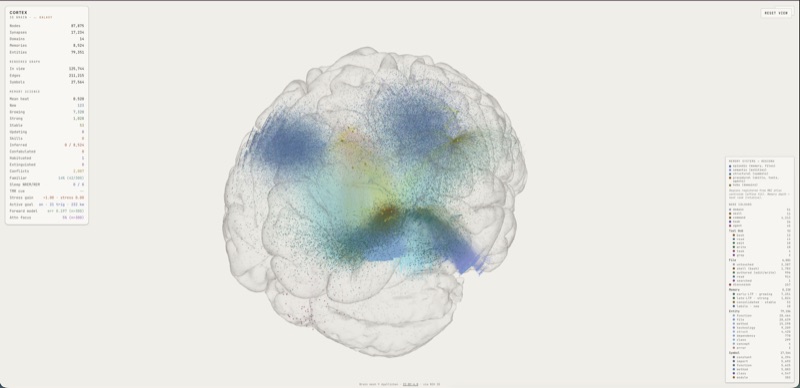
Visualisation en lecture seule pour Cortex (anciennement cortex-viz).
Garde de contexte, raffinement de prompts et statusline.
Publics et fonctionnels, encore en cours d'amélioration : versions antérieures à 1.0, ou pas encore de processus de release et de CI. À utiliser en connaissance de cause.
Chaque composant est open source, sous licence MIT, et tourne en production. Le choix, c'est de recevoir le système clé en main — ou les clés pour le faire vous-même.
La méthode appliquée aux migrations de code et d'outils, vendues au prix fixe par livrable, pas au temps passé. Un court pilote payant sur votre propre code mesure d'abord la vitesse réelle ; le prix découle de la mesure. Aucun tarif publié.
Si vous construisez avec l'IA vous-même, utilisez les mêmes composants que ceux que nous utilisons en production. Les outils mûrs d'abord ; AI Architect Codebase et AI Architect Spec sont encore en développement. Chacun a son propre dépôt, documenté, sous licence MIT, sans verrouillage.
Chaque engagement suit la même séquence — sans jeu de diapositives, sans théâtre de « transformation IA ». Chaque étape produit un artefact visible et daté avant que nous demandions le prochain engagement.
Un inventaire de votre surface IA — quel outillage existe déjà, ce qui relève du shadow IT, où la connaissance dérive silencieusement entre systèmes. Ce document est le vôtre, à utiliser avec ou sans nous.
Voir comment nous procédonsCadrer, déployer, configurer, exécuter — exactement la même séquence d'activation à chaque fois. Nous connectons Claude Code à vos vrais dépôts, vos vraies données, votre vrai processus de revue.
Voir comment nous procédonsUn pilote payant et cadré sur un vrai workflow, avec des livrables visibles au fur et à mesure — aucune boîte noire. Vous observez l'agent travailler avant de vous engager au-delà du pilote.
Voir comment nous procédonsDeux façons de le faire tourner en production : l'édition locale, sur votre propre infrastructure sans dépendance envers nous, ou Claude Enterprise, gérée avec une mémoire et une gouvernance à l'échelle de l'organisation. Dans les deux cas, vous possédez ce qui est livré.
Voir comment nous procédons
Le socle : quinze ans d'ingénierie mobile sur iOS et Android, et une expérience de la finance réglementée (banque privée, Luxembourg), où « ça marche à peu près » ne part jamais en production. Chaque système doit être testé, vérifié, auditable. Sinon, il ne sort pas.
J'applique la même exigence à l'IA. J'ai lancé AI Architect parce que je voyais toujours le même anti-pattern : des équipes qui traitent les agents comme des démos, empilent les prompts sur les prompts, demandent à un autre LLM si le premier a bien fait, et se demandent pourquoi rien ne tient en production.
Le travail ici est zététique — chaque affirmation est investiguée, jamais présumée. Les outils sont open source parce que la frontière doit être partagée. Le conseil existe parce que certaines équipes ont besoin que le système soit construit avec elles, pas qu'on leur remette un dépôt et une prière.
« Un agent sans mémoire n'est pas intelligent. Un agent sans vérification n'est pas fiable. Je ne m'intéresse qu'à construire les deux. »
Une architecture structurée d'assemblage de contexte qui récupère la dégradation géométrique de la récupération vectorielle dense à l'échelle de 10 millions de tokens. Deux primitives : un décomposeur de prompt à budget priorisé avec condenseurs sensibles au domaine, et un assembleur en deux phases sensible aux étapes avec sélection de couverture sous-modulaire, traversée de graphe d'entités par Personalized PageRank, et repli sur résumé structuré par schéma.
Sur BEAM-10M, l'assembleur atteint 0,471 MRR — soit +33,4 % par rapport à la base plate, avec 8 des 10 capacités de mémoire améliorées. Conçu à l'origine en septembre 2025 pour la fenêtre de 4 096 tokens d'Apple Intelligence — un mois avant la publication du benchmark BEAM lui-même.
La mémoire externe des LLM est dominée par des magasins à importance plate — index vectoriels, corpus BM25, tampons à long contexte — dans lesquels chaque élément porte le même a priori de récupération à long terme. Cette conception est asymptotiquement défaillante : à mesure que le corpus grandit, la récupération des top-k dégénère en un départage quasi arbitraire.
Cet article formalise cet effondrement et décrit Cortex, une architecture de mémoire qui maintient une distribution de priorité non plate sur N en couplant quatre mécanismes : une chaleur à décroissance continue (Ebbinghaus), une porte d'écriture hiérarchique à codage prédictif (Friston), des cascades de consolidation (Kandel, McClelland), et la fusion WRRF avec la chaleur comme départageur. Les chiffres ci-dessus sont ceux de l'article, chacun issu de son run et de son protocole nommés. Le chiffre de release actuel sur cette page (97,8 % de Recall@10 sur LongMemEval-S) provient de la mesure de la v4.20.0 du 9 septembre 2026, le benchmark de référence du README de Cortex.
Cortex s'appuie sur une bibliographie de 97 articles en neuroscience, recherche sur la mémoire et évaluation de l'IA. Quelques-uns des piliers :
/plugin marketplace add cdeust/Cortex puis /plugin install hypermnesia-mcp ; il fonctionne aussi dans Codex, Gemini CLI et les autres hôtes MCP stdio./plugin marketplace add cdeust/Cortex/plugin install hypermnesia-mcp/plugin install hypermnesia-mcp-viz@cortex-plugins/plugin marketplace add cdeust/ai-architect-mcp-codebase/plugin install ai-architect-mcp-codebase@ai-architect-mcp-codebase-marketplace/plugin marketplace add cdeust/ai-architect-mcp-spec/plugin install ai-architect-mcp-spec@ai-architect-mcp-spec-marketplace/plugin marketplace add cdeust/session-optimizer/plugin install context-guard@session-optimizer-marketplaceUn appel de 30 minutes. Sans jeu de diapositives, sans engagement. Les migrations commencent par un court pilote payant sur votre propre code. Si votre problème ne correspond pas à ce que nous faisons, nous vous orienterons ailleurs.